RAG vs CAG vs KAG: Apa Bedanya dan Kapan Digunakan? Panduan Lengkap untuk Pemula
Ilustrasi editorial dibuat dengan ImageGen. Seluruh gambar konseptual dalam artikel ini bukan tangkapan layar aplikasi, dokumentasi pengujian, atau bukti performa. Diagram alur dibuat secara deterministik untuk menjaga ketepatan label.
Anda sudah mempunyai kumpulan dokumen, tetapi jawaban AI masih terasa umum. Ketika ditanya aturan pengembalian barang, AI malah memberikan kebijakan toko lain. Ketika diminta merangkum beberapa pedoman, ada pengecualian yang terlewat. Masalah seperti ini membuat pertanyaan berikut menjadi penting: bagaimana sebenarnya aplikasi memberikan pengetahuan yang tepat kepada AI sebelum AI menjawab?
RAG, CAG, dan KAG menawarkan pendekatan yang berbeda. RAG mengambil informasi relevan ketika pertanyaan datang. CAG yang dibahas di sini menyiapkan pengetahuan terbatas di dalam konteks model dan menggunakan kembali cache pemrosesannya. KAG dalam kerangka OpenSPG menggabungkan hubungan pengetahuan, pencarian, dan penalaran. Ketiganya tidak membentuk tangga sederhana dari versi lama menuju versi paling pintar. Dasar definisinya dapat diperiksa pada paper RAG oleh Lewis dkk. (2020/05), paper CAG oleh Chan dkk. (2024/12), dan paper KAG oleh Liang dkk. (2024/09).
Panduan ini ditujukan bagi pemilik usaha, pengelola sekolah, staf administrasi, pembuat konten, dan pembaca yang sedang merancang asisten AI. Anda tidak perlu mengikuti kode untuk memahami artikel ini. Kita memakai satu toko fiktif agar pilihan arsitektur terasa konkret, lalu menyusun langkah percobaan yang dapat dibawa ke pengembang. Semua skenario toko, angka, dan jawaban contoh merupakan bahan belajar buatan redaksi; tidak diambil dari transaksi pelanggan atau hasil menjalankan model.
Jika Anda sebelumnya mengikuti pembahasan karyawan AI lokal per divisi di Tumbas.in, artikel ini membahas lapisan pengetahuannya. Nama asisten dan pembagian peran membantu mengatur pekerjaan, sedangkan sumber, konteks, dan aturan akses menentukan bahan yang boleh dipakai untuk menjawab. Memahami perbedaan tersebut membantu Anda menentukan bagian mana yang sebenarnya perlu dibangun.
1. Istilah penting sebelum membandingkan RAG, CAG, dan KAG
Tabel ini menjadi kamus kerja artikel. Definisi dibuat singkat; rincian mekanisme dibahas sesudahnya. Istilah umum dalam nama pendekatan juga diterjemahkan supaya singkatan tidak menjadi penghalang pemahaman.
| Istilah | Arti dalam artikel |
|---|---|
| AI atau kecerdasan buatan | Sistem komputasi untuk mengerjakan tugas yang biasanya memerlukan kemampuan seperti mengenali pola atau menghasilkan bahasa. |
| Model bahasa besar atau LLM | Model yang mempelajari pola bahasa dan menghasilkan teks berdasarkan masukan serta parameter hasil pelatihannya. |
| Retrieval | Proses mencari atau mengambil informasi yang diperlukan dari sumber yang tersedia. |
| Augmented | Diperkuat atau dilengkapi dengan bahan tambahan. |
| Generation | Proses menghasilkan keluaran, misalnya jawaban dalam bentuk kalimat. |
| RAG | Retrieval-Augmented Generation, pendekatan yang melengkapi proses menghasilkan jawaban dengan informasi hasil pencarian. |
| Cache | Penyimpanan sementara hasil pemrosesan agar sebagian pekerjaan dapat digunakan kembali. |
| CAG | Cache-Augmented Generation, pendekatan yang memuat pengetahuan ke konteks model dan memakai kembali cache pemrosesannya untuk menjawab. |
| Knowledge | Pengetahuan, berupa fakta, konsep, aturan, atau hubungan yang digunakan dalam suatu bidang. |
| KAG | Knowledge Augmented Generation; pembahasan ini khusus mengacu pada kerangka OpenSPG. |
| Konteks dan context window | Konteks adalah bahan masukan yang dapat diperhatikan model; context window adalah batas kapasitasnya. |
| Token | Satuan pemrosesan teks model; satu token tidak selalu sama dengan satu kata. |
| Prompt | Instruksi atau masukan yang diberikan kepada model. |
| Chunk | Potongan dokumen yang dibuat untuk memudahkan pengindeksan dan pengambilan informasi. |
| Metadata | Keterangan sumber, seperti nama dokumen, versi, tanggal berlaku, dan hak akses. |
| Indeks | Struktur untuk membantu menemukan informasi tanpa memeriksa seluruh sumber satu per satu. |
| Embedding dan vektor | Embedding adalah representasi data berupa deretan angka atau vektor yang dapat digunakan dalam pencarian kemiripan. |
| Pencarian semantik | Pencarian berdasarkan kemiripan makna, tidak hanya kesamaan kata yang tertulis. |
| BM25 dan pencarian hibrida | BM25 adalah metode pemeringkatan berbasis kecocokan istilah; pencarian hibrida menggabungkan beberapa cara pencarian. |
| Reranking | Penilaian ulang kandidat hasil pencarian untuk mengurutkan sumber yang lebih relevan. |
| KV cache | Simpanan key dan value dari pemrosesan perhatian model; berbeda dari sekadar menyimpan jawaban lama. |
| Parameter dan fine-tuning | Parameter adalah nilai yang dipelajari model; fine-tuning adalah pelatihan lanjutan untuk menyesuaikan parameter. |
| Knowledge graph | Representasi pengetahuan sebagai entitas dan hubungan di antara entitas tersebut. |
| Entitas, relasi, dan skema | Entitas adalah objek yang dibahas, relasi menghubungkan objek, dan skema menentukan jenis data serta hubungan yang diperbolehkan. |
| Multi-hop | Penelusuran beberapa hubungan atau langkah informasi untuk menjawab satu pertanyaan. |
| GraphRAG | Pendekatan RAG berbasis graf; contoh dalam artikel mengacu pada proyek Microsoft Research. |
| Agentic RAG | Rancangan yang memberi agen kemampuan mengatur langkah pencarian atau penggunaan alat. |
| Self-RAG dan CRAG | Dua pendekatan penelitian: refleksi pada pengambilan serta pembuatan jawaban, dan koreksi ketika hasil pencarian kurang memadai. |
| Contextual Retrieval | Teknik memberi konteks tambahan pada potongan dokumen sebelum pengindeksan. |
| Halusinasi | Keluaran yang tampak meyakinkan tetapi tidak didukung fakta atau bahan yang semestinya. |
| Sitasi | Penunjuk sumber yang mendasari klaim atau bagian jawaban. |
| Latensi | Waktu tunggu suatu proses, misalnya sampai jawaban mulai muncul atau selesai. |
| Benchmark | Pengujian dengan data dan prosedur tertentu untuk membandingkan performa. |
| API dan runtime | API adalah antarmuka komunikasi program; runtime adalah perangkat lunak yang menjalankan model atau aplikasi. |
| Ollama dan OpenSPG | Ollama adalah perangkat untuk menjalankan model; OpenSPG adalah mesin pengetahuan yang menjadi dasar kerangka KAG. |
| Prompt injection | Masukan yang mencoba mengubah perilaku model melalui instruksi yang tidak semestinya diikuti. |
| Lokal dan cloud | Lokal berarti pemrosesan di perangkat yang dikelola sendiri; cloud berarti menggunakan layanan komputasi jarak jauh. |
Definisi retrieval dan generation mengikuti konsep Lewis dkk. (2020/05); embedding dijelaskan dalam dokumentasi Ollama, diakses 2026/10; cache dalam CAG mengikuti repositori peneliti CAG, diakses 2026/10. Istilah graf dan skema mengacu pada OpenSPG/KAG, diakses 2026/10. Istilah evaluasi pada tabel dipakai sebagai definisi operasional panduan ini, bukan sebagai standar sertifikasi.
2. Mengapa AI memerlukan sumber pengetahuan tambahan?
Jawaban lancar belum menunjukkan bahwa sumbernya benar
Bayangkan Toko Lentera menjual perlengkapan rumah. Pengelola memiliki katalog, panduan garansi, daftar wilayah pengiriman, dan aturan retur. Ketika pelanggan bertanya apakah barang tertentu boleh dikembalikan, jawaban yang dibutuhkan adalah kebijakan Lentera yang berlaku pada transaksi tersebut. Uraian umum tentang praktik toko online belum menyelesaikan kebutuhan pelanggan. Dalam contoh ini, masalah pertama bukan panjang jawaban, melainkan pemilihan fakta yang boleh digunakan.
Model dapat menghasilkan kalimat tanpa mempunyai akses ke dokumen internal toko. Paper RAG membahas penggabungan pengetahuan dalam parameter model dengan penyimpanan eksternal yang dapat diambil saat menghasilkan jawaban. Artinya, sumber tambahan menjadi bagian penting rancangan aplikasi, bukan sekadar lampiran dekoratif. Namun, kemampuan menyertakan sumber tidak otomatis membuktikan setiap jawaban benar. Kesesuaian informasi dan klaim masih perlu diperiksa. Lewis dkk. (2020/05), abstrak.
Untuk memahaminya, pisahkan tiga pertanyaan. Pertama, apakah informasi tersedia dalam bahan yang diizinkan? Kedua, apakah aplikasi berhasil menyediakan bagian yang tepat kepada model? Ketiga, apakah model menggunakan bagian itu secara benar? Jika aturan retur belum pernah ditulis, mesin pencari sebagus apa pun tidak dapat menemukan ketentuan resmi toko. Jika aturan sudah ada tetapi terpotong dari pengecualiannya, masalahnya berbeda. Jika bahan benar tetapi kesimpulan salah, pemeriksaan harus beralih ke tahap pembuatan jawaban.
Mengunggah dokumen bukan berarti melatih ulang model
Dalam rancangan RAG umum, aplikasi mengambil bahan dan memasukkannya ke konteks ketika pertanyaan diproses. Pada CAG yang dibahas di sini, pengetahuan yang terkendali dimuat terlebih dahulu dan hasil pemrosesannya digunakan kembali. Keduanya perlu dibedakan dari mengubah parameter model melalui pelatihan lanjutan. Paper awal RAG memang meneliti pelatihan komponen model; hal itu tidak berarti semua aplikasi RAG saat ini harus melatih ulang model. Lewis dkk. (2020/05); Chan dkk. (2024/12).
Sebagai panduan memilih, tanyakan perubahan apa yang sedang Anda kejar. Jika kebijakan toko baru disahkan, kebutuhan utamanya adalah memastikan versi baru tersedia dan versi lama tidak dipakai sembarangan. Jika gaya jawaban harus singkat dan konsisten, masalahnya mungkin berada pada instruksi dan pemeriksaan format. Jika kemampuan mengikuti tugas khusus tetap buruk meskipun sumber benar, barulah kebutuhan pelatihan dapat dievaluasi secara terpisah. Contoh ini adalah cara memetakan pekerjaan, bukan pernyataan bahwa satu teknik selalu menyelesaikan semua kebutuhan.
Data yang berbeda menghasilkan kebutuhan yang berbeda
Sebuah buku panduan kecil yang jarang berubah menimbulkan kebutuhan berbeda dari ribuan catatan layanan yang bertambah setiap hari. Begitu pula pertanyaan tentang satu kalimat berbeda dari pertanyaan yang memerlukan hubungan produk, penjual, tanggal, dan pengecualian kebijakan. Karena itu, pilih pendekatan setelah mengenali bahan serta bentuk pertanyaan. Hindari memulai dari nama singkatan yang terlihat paling baru, lalu memaksa seluruh data masuk ke dalamnya.
Untuk proyek pertama Lentera, redaksi menyarankan daftar sederhana: dokumen apa yang boleh dibaca, siapa pemiliknya, kapan berlaku, siapa pembacanya, dan contoh pertanyaan yang harus dijawab. Daftar ini akan dipakai kembali pada bagian percobaan. Nilainya praktis: Anda dapat mengidentifikasi kekosongan sumber sebelum membayar proses pengindeksan, menyusun cache, atau membangun graf. Belum ada klaim tentang peningkatan performa pada tahap ini karena belum ada sistem yang dijalankan.
3. Bagaimana RAG, CAG, dan KAG bekerja?
RAG: mencari bahan yang relevan ketika pertanyaan datang
Ilustrasi ImageGen: memilih bahan yang relevan dari arsip. Metafora ini menyederhanakan mekanisme; alur aplikasi ditunjukkan pada diagram berikut.
Pada pola RAG berbasis dokumen yang umum, ada tahap persiapan dan tahap pertanyaan. Saat persiapan, isi dokumen diekstrak, dibagi menjadi potongan, diberi metadata, kemudian diindeks. Saat pengguna bertanya, sistem mencari potongan yang relevan dan menyediakan hasilnya kepada model sebagai bahan jawaban. Dokumentasi Anthropic menjelaskan pola potongan, embedding, penyimpanan vektor, dan pengambilan informasi tersebut. Anthropic, Contextual Retrieval, diakses 2026/10, primer RAG.
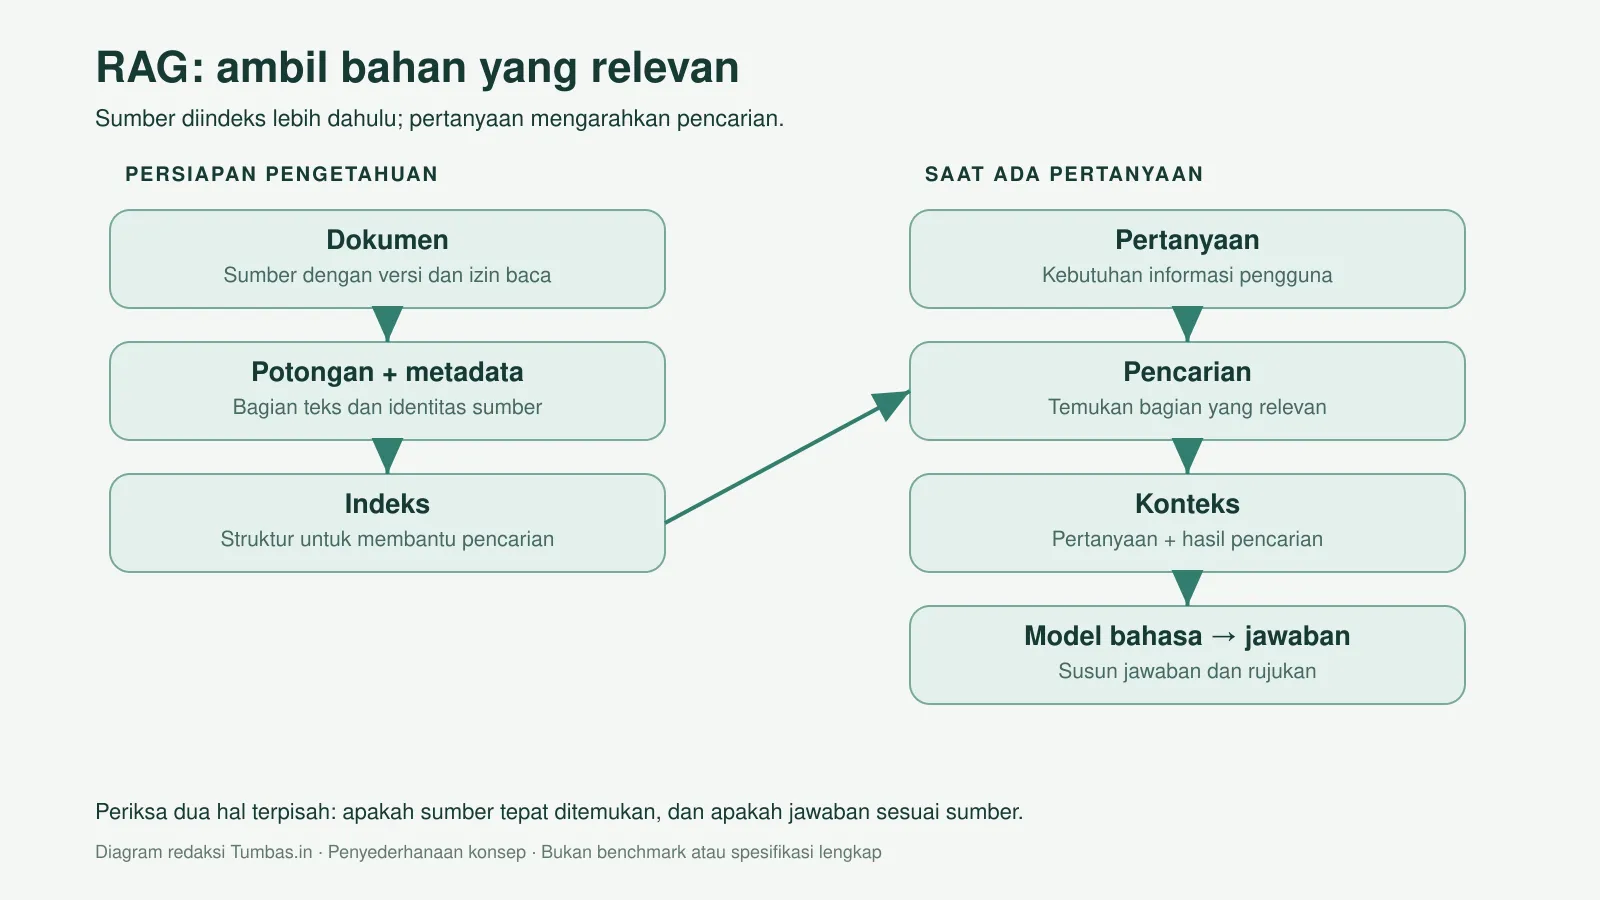
Diagram redaksi: sumber disiapkan lebih dahulu, lalu pertanyaan digunakan untuk mengambil konteks yang relevan. Panah menunjukkan alur informasi, bukan ukuran waktu atau biaya.
Dalam contoh Lentera, pertanyaan “Berapa batas waktu retur lampu meja?” seharusnya mengarahkan pencarian ke kebijakan retur dan informasi kategori produk yang sesuai. Model tidak perlu membaca seluruh arsip jika bahan yang diperlukan dapat dipilih dengan baik. Setelah sumber dipilih, jawaban yang diharapkan menyebut ketentuan relevan serta identitas dokumennya. Ini adalah rancangan keluaran dalam contoh, bukan hasil uji sistem RAG tertentu.
Kemiripan makna membantu ketika kata pelanggan berbeda dari kata dokumen. Misalnya, pelanggan mengatakan “mengembalikan barang”, sedangkan judul pedoman menggunakan “retur”. Namun, nomor model produk atau kode pasal kadang memerlukan kecocokan istilah yang lebih tepat. Pencarian hibrida dapat menggabungkan pencarian semantik dengan BM25, kemudian menyatukan hasilnya. Reranking dapat menilai ulang kandidat sebelum bahan dimasukkan ke konteks. Anthropic, diakses 2026/10, primer RAG dan reranking.
Kegagalan perlu dilacak per tahap. Jika pencarian hanya menemukan dokumen lama, memperpanjang jawaban tidak memperbaiki sumbernya. Jika daftar kandidat memuat aturan baru tetapi yang dimasukkan ke konteks justru aturan umum, periksa pemilihan kandidat. Jika kedua aturan sudah masuk tetapi model mengabaikan pengecualian, periksa cara pertanyaan dan konteks disusun. Urutan diagnosis ini adalah saran redaksi supaya perubahan dilakukan pada bagian yang benar, bukan percobaan acak mengganti model.
RAG juga tidak terbatas pada satu produk penyimpanan. Paper aslinya menggunakan indeks vektor eksternal, sedangkan ragam aplikasi dapat memilih mekanisme pengambilan sesuai bahan. Untuk pembaca pemula, hal yang perlu dipertahankan adalah pemisahan antara menyimpan bahan, menemukan bahan, dan menyusun jawaban. Tiga tahap tersebut memberi tempat yang jelas untuk melakukan pemeriksaan. Lewis dkk. (2020/05), abstrak.
CAG: menyiapkan pengetahuan dan memakai kembali cache
Ilustrasi ImageGen: bahan terbatas disiapkan lebih dahulu. Buku pada gambar adalah metafora konteks siap pakai, bukan bukti bahwa model dilatih ulang.
CAG dalam artikel ini berarti Cache-Augmented Generation dari penelitian Chan dan rekan. Gagasannya adalah memasukkan sumber pengetahuan yang relevan ke konteks model lebih dahulu, kemudian menggunakan cache pemrosesan saat menjawab pertanyaan. Repositori penelitinya menjelaskan penggunaan KV cache. Karena tidak perlu melakukan pencarian dokumen pada setiap pertanyaan, sebagian tahap pengambilan informasi dapat dihindari. Chan dkk. (2024/12), abstrak; repositori CAG, diakses 2026/10.
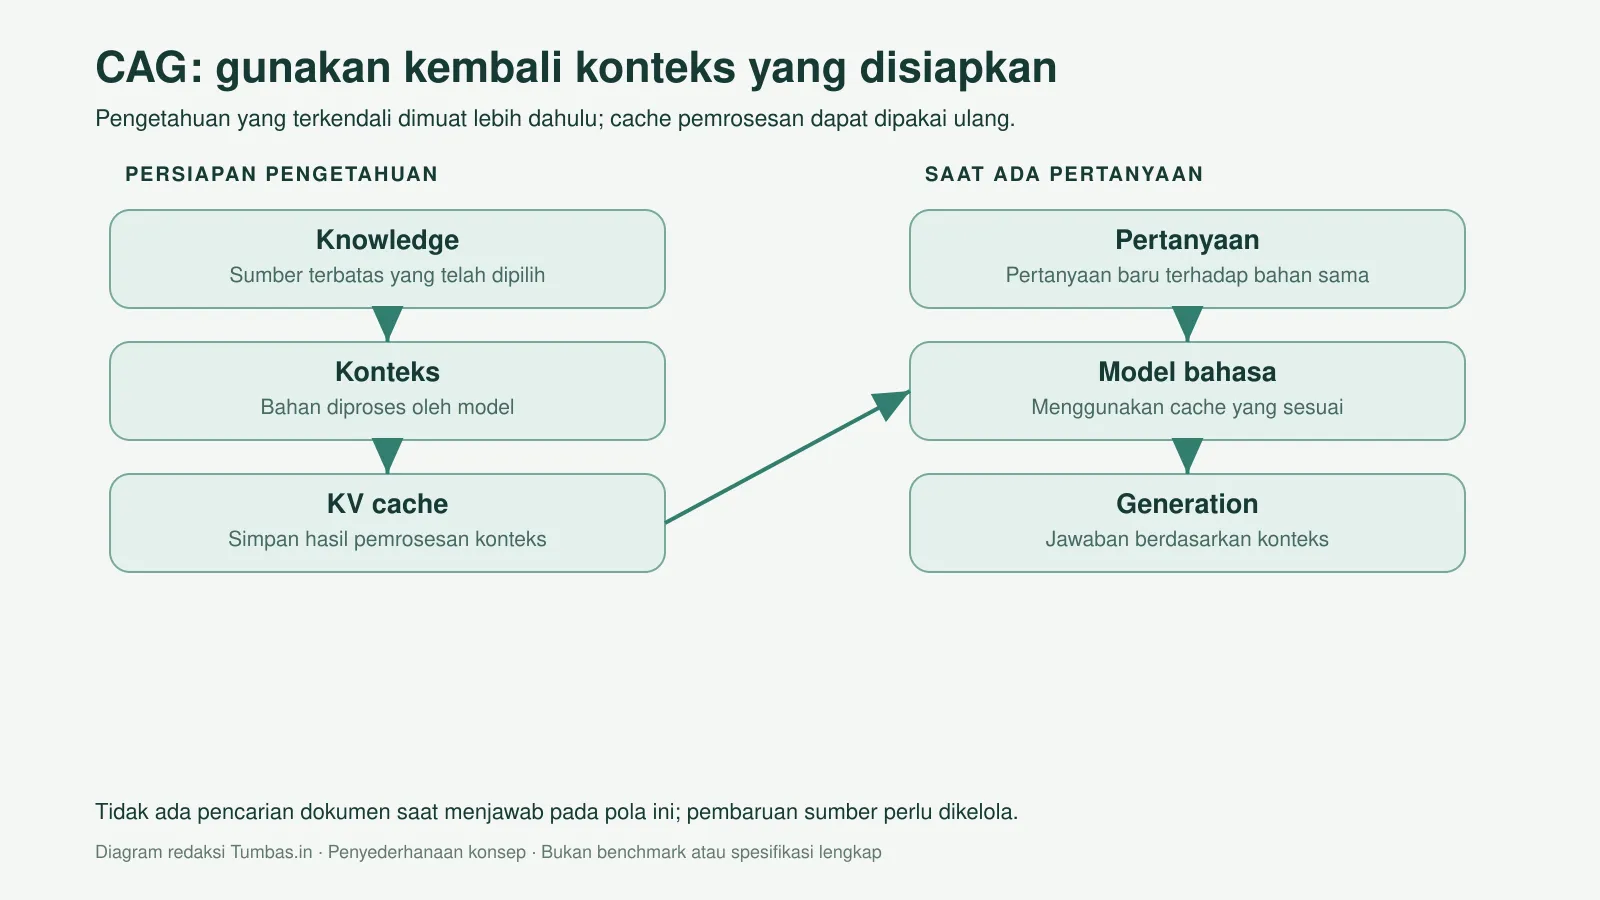
Diagram redaksi: persiapan pengetahuan mendahului pertanyaan. Penggunaan ulang cache membutuhkan dukungan sistem; mengunggah berkas saja tidak membuktikan cache digunakan.
Perhatikan tiga hal yang berbeda: memuat seluruh panduan ke prompt, memakai kembali cache pemrosesannya, dan menyimpan jawaban yang pernah diberikan. Artikel ini tidak menyamakan ketiganya. Jika aplikasi hanya menyalin seluruh dokumen pada setiap permintaan tanpa mekanisme penggunaan ulang yang sesuai, itu belum menunjukkan implementasi CAG seperti yang dimaksud penelitian. Begitu pula mengembalikan jawaban lama untuk pertanyaan identik merupakan bentuk penyimpanan hasil, bukan penjelasan lengkap tentang KV cache. Repositori CAG, diakses 2026/10, Overview dan Usage.
Untuk Lentera, kandidat percobaan CAG adalah buku kebijakan yang kecil, telah disetujui, dan tidak berubah selama satu periode uji. Tim menetapkan satu paket pengetahuan, kemudian mengajukan pertanyaan yang berbeda terhadap paket yang sama. Apabila ada revisi ketentuan, paket itu diberi versi baru dan proses penyiapannya harus diperiksa kembali. Contoh pengelolaan versi ini merupakan rancangan redaksi; ia tidak menetapkan satu mekanisme pembaruan cache yang wajib berlaku pada semua runtime.
Keterbatasannya penting. Pengetahuan yang dipakai perlu muat dalam kapasitas konteks yang sesuai, dan konteks panjang tidak menjamin model selalu menemukan setiap detail. Repositori CAG menyebut keterbatasan ukuran pengetahuan serta kemungkinan penurunan kualitas pada konteks yang sangat panjang. Dokumentasi Ollama juga menjelaskan bahwa memperbesar konteks meningkatkan kebutuhan memori. Karena itu, jangan mengubah “dokumen bisa dimasukkan” menjadi “pasti cepat dan akurat”. CAG, diakses 2026/10, Limitations; Ollama, diakses 2026/10, Context length.
Cara menilainya adalah membedakan biaya persiapan dari biaya pertanyaan berikutnya. Catat waktu menyiapkan bahan, waktu respons setelah cache siap, kebutuhan memori, serta tindakan ketika dokumen diperbarui. Jika hanya mengukur pertanyaan kedua tanpa mencatat penyiapan pertama, pembaca perbandingan kehilangan bagian penting. Pedoman pengukuran ini adalah usulan percobaan, bukan angka performa CAG yang telah dibuktikan pada laptop tertentu.
KAG: menghubungkan fakta, aturan, dan penelusuran sumber
Ilustrasi ImageGen: fakta dan aturan disusun sebagai hubungan. Graf sebenarnya harus dibangun dari sumber dan diperiksa; benang pada gambar hanya metafora.
KAG yang dimaksud adalah kerangka Knowledge Augmented Generation berbasis OpenSPG. Paper dan repositorinya menjelaskan pemanfaatan knowledge graph bersama pengambilan teks, pengindeksan timbal balik antara graf dan potongan asli, serta penalaran yang dipandu bentuk logis. Tujuannya menyokong pertanyaan bidang khusus yang membutuhkan fakta dan hubungan lebih terstruktur. Ini bukan nama umum untuk semua aplikasi yang sekadar mengunggah pengetahuan. Liang dkk. (2024/09); OpenSPG/KAG, diakses 2026/10, What is KAG.
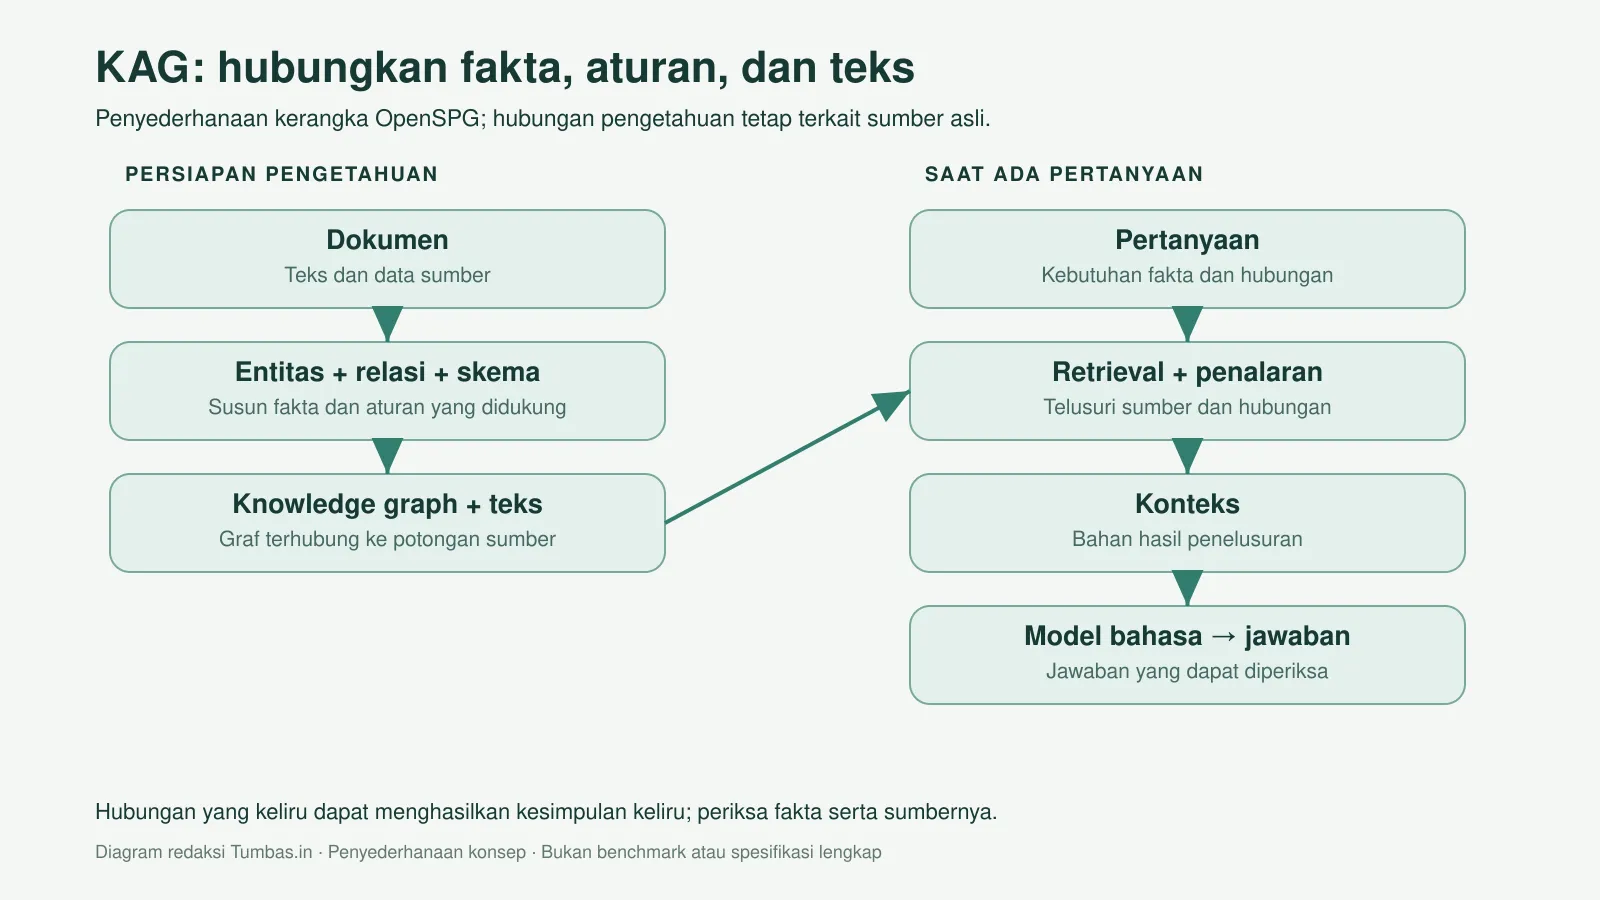
Diagram redaksi yang menyederhanakan KAG: graf dan teks tetap terhubung sebagai bahan penelusuran. Diagram bukan spesifikasi lengkap komponen OpenSPG.
Pada Lentera, kita dapat mendefinisikan entitas produk, kategori, transaksi, dan kebijakan. Relasi menyatakan bahwa produk berada pada kategori tertentu, transaksi menggunakan versi kebijakan tertentu, dan pengecualian berlaku untuk kategori tertentu. Dengan rancangan seperti itu, pertanyaan tidak hanya mencari kalimat mirip. Sistem diharapkan menggabungkan fakta yang tersebar untuk menentukan informasi relevan. Struktur toko tersebut adalah contoh buatan redaksi, bukan contoh resmi yang diklaim pernah diterapkan oleh peneliti KAG.
Ambil pertanyaan “Untuk barang kategori A yang dibeli sebelum kebijakan baru berlaku, dokumen mana yang harus dijadikan acuan?” Jawaban memerlukan kategori, tanggal transaksi, tanggal berlaku, serta ketentuan peralihan. Jika salah satu hubungan tidak tersedia, aplikasi harus menunjukkan kekurangannya. Jangan membuat hubungan sendiri hanya karena dua kalimat terdengar berkaitan. Paper KAG membahas persoalan nilai numerik, relasi waktu, dan aturan ahli sebagai motivasi pengetahuan terstruktur. Liang dkk. (2024/09), abstrak.
Menambahkan graf juga menambahkan pekerjaan pengelolaan. Dalam percobaan yang disarankan, tim perlu menetapkan nama kategori yang konsisten, sumber setiap relasi, dan siapa yang boleh menyetujui aturan. Dua dokumen mungkin memakai istilah berbeda untuk barang yang sama; penyamaan istilah harus mempunyai dasar. Jika simpul salah digabung, penelusuran hubungan menjadi rapi tetapi keliru. Rancangan pemeriksaan ini mendukung tujuan belajar; ia tidak menggantikan peninjauan oleh pemilik kebijakan.
Repositori KAG menjelaskan mekanisme ekstraksi dengan skema, penyelarasan pengetahuan, dan kombinasi pencarian serta penalaran. Kemampuan itu memberi bahan untuk merancang sistem yang lebih terstruktur, tetapi klaim keberhasilan penelitian harus dibaca bersama data serta prosedur uji penulis. Artikel ini tidak menyimpulkan KAG selalu lebih baik daripada RAG untuk seluruh pertanyaan, bahasa, perangkat, atau organisasi. OpenSPG/KAG, diakses 2026/10, Core Features dan Technical Architecture.
Perbandingan yang lebih berguna daripada mencari pemenang
Ilustrasi ImageGen: bobot visual ketiganya setara. Pilihan dalam tabel adalah panduan awal redaksi, bukan hasil benchmark.
| Pertanyaan keputusan | RAG | CAG | KAG OpenSPG |
|---|---|---|---|
| Bahan utama yang dikelola | Sumber dan indeks pencarian | Paket pengetahuan dalam konteks beserta cache | Fakta, hubungan, aturan, serta teks sumber |
| Kegiatan saat menjawab | Mengambil bagian relevan | Menggunakan pengetahuan yang sudah disiapkan | Menelusuri dan menggabungkan pengetahuan dengan mekanisme penalaran |
| Hal pertama yang perlu diuji | Apakah sumber yang tepat berhasil diambil? | Apakah bahan muat dan cache benar digunakan? | Apakah fakta dan relasi benar serta dapat ditelusuri? |
| Contoh kandidat proyek | Arsip dokumen yang berkembang | Panduan kecil yang relatif tetap | Pertanyaan dengan hubungan dan aturan lintas sumber |
| Pekerjaan pemeliharaan dalam pilot | Memperbarui indeks dan metadata | Mengganti paket pengetahuan dan memeriksa cache | Memperbarui fakta, aturan, skema, dan tautan sumber |
Bagian mekanisme dalam tabel merupakan ringkasan paper RAG, repositori CAG, dan repositori KAG, diperiksa 2026/10. Kandidat proyek, pertanyaan uji, dan pemeliharaan adalah rekomendasi desain redaksi. Tabel tidak menetapkan biaya atau waktu yang universal, sebab implementasi serta datanya belum ditentukan.
GraphRAG dan pendekatan lain: mana yang benar-benar berbeda?
GraphRAG dari Microsoft Research membangun graf dari teks, menyusun kelompok hubungan, dan membuat ringkasan kelompok. Dokumentasinya membedakan pencarian global untuk gambaran menyeluruh dengan pencarian lokal yang memusatkan perhatian pada entitas dan konteks terkait. KAG dan GraphRAG sama-sama memakai struktur pengetahuan, tetapi kerangka, cara membangun representasi, dan jalur penalarannya tidak boleh dianggap identik. Microsoft GraphRAG, diakses 2026/10, Overview; Global Search; Local Search.
Agentic RAG membahas pengaturan langkah: agen dapat memilih alat pencarian, memecah kebutuhan informasi, atau melakukan pencarian lanjutan. Dokumentasi LlamaIndex menjelaskan agen yang memakai alat untuk bekerja dengan data serta komponen pengambilan informasi. Untuk proyek Lentera, itu dapat dijadikan arah percobaan lanjutan setelah satu pencarian dasar sudah dapat diperiksa. Penggunaan agen pada contoh toko merupakan usulan redaksi, bukan implementasi yang telah diuji. LlamaIndex Framework, diakses 2026/10.
Self-RAG adalah pendekatan penelitian yang melatih model menggunakan token refleksi untuk mengatur pengambilan dan mengevaluasi bahan serta hasil generasi. Menambahkan kalimat “periksa jawabanmu” pada prompt tidak otomatis sama dengan metode itu. Corrective RAG atau CRAG menilai kualitas dokumen hasil pencarian dan menentukan tindakan koreksi; penelitian tersebut juga memakai pencarian web sebagai perluasan sumber. Asai dkk. (2023/10), abstrak; Yan dkk. (2024/01), abstrak.
Contextual Retrieval berada pada penyiapan informasi. Potongan teks diberi keterangan konteks dokumen sebelum embedding dan pengindeksan berbasis istilah. Contoh sederhananya adalah memperjelas bahwa kalimat “berlaku tujuh hari” membahas retur barang kategori tertentu, bukan masa garansi. Contoh kalimat itu dibuat redaksi, sedangkan teknik pemberian konteks mengikuti penjelasan resmi Anthropic. Anthropic, diakses 2026/10, Introducing Contextual Retrieval.
Keseluruhan nama tersebut tidak berada pada satu tingkat yang sama. Ada pendekatan penyediaan bahan, teknik peningkatan pencarian, pengaturan tindakan agen, dan metode pelatihan model. Dalam rencana kerja, tuliskan masalah yang ingin diperbaiki sebelum menambahkan nama teknologi. Dengan begitu Anda dapat menjelaskan mengapa suatu komponen dipakai dan bagaimana keberhasilannya akan diperiksa, tanpa menganggap penambahan singkatan sebagai kemajuan dengan sendirinya.
4. Contoh konkret: merancang asisten pengetahuan Toko Lentera
Ilustrasi ImageGen. Toko Lentera, dokumen, produk, dan transaksi pada penjelasan berikut sepenuhnya fiktif untuk latihan.
Langkah 1: tetapkan pekerjaan yang ingin dibantu
Mulailah dengan satu kalimat tujuan: “Asisten membantu staf menemukan ketentuan retur dari dokumen yang sudah disetujui.” Kalimat ini lebih mudah diuji daripada “asisten memahami semua urusan toko”. Tetapkan pula batasnya: asisten memberikan penjelasan dan rujukan, sedangkan persetujuan pengembalian dana tetap dilakukan staf. Pembatasan tersebut merupakan keputusan rancangan contoh supaya hasil percobaan jelas dan dapat diperiksa.
Tentukan pengguna pertama. Jika asisten dipakai staf layanan, bahan internal mungkin diperlukan. Jika dipakai pelanggan, hanya bahan yang memang boleh dipublikasikan yang disediakan. Jangan memulai percobaan dengan semua folder lalu baru memikirkan siapa boleh membaca apa. Dalam dokumen kerja pilot, tuliskan siapa pengguna, pertanyaan yang diizinkan, keluaran yang diharapkan, dan siapa penanggung jawab koreksi. Rincian ini menjadi kesepakatan sebelum teknologi dipilih.
Untuk versi pertama, pilih tugas mencari ketentuan dan menyebut sumber. Hindari sekaligus meminta rekomendasi produk, mengubah stok, mengirim pesan, dan menyetujui retur. Bukan berarti seluruh fungsi tersebut mustahil digabung, tetapi percobaan kecil membuat penyebab kegagalan lebih mudah dikenali. Jika jawaban salah, tim dapat meneliti pencarian serta penyimpulan tanpa harus memeriksa banyak tindakan lain yang terjadi bersamaan.
Langkah 2: siapkan empat dokumen contoh
Untuk latihan, buat empat berkas fiktif. Jangan memakai dokumen pelanggan nyata ketika tujuan awalnya hanya memeriksa alur. Beri setiap berkas judul, versi, pemilik, dan tanggal berlaku. Di bawah ini adalah paket buatan redaksi; ketentuannya tidak merepresentasikan aturan hukum atau standar usaha yang harus diikuti pembaca.
| Berkas latihan | Isi contoh | Fungsi dalam percobaan |
|---|---|---|
| Kebijakan Retur v1 | Retur barang biasa dapat diajukan dalam tujuh hari setelah diterima; barang personalisasi dikecualikan. | Menguji aturan umum dan pengecualian. |
| Daftar Produk v1 | Lampu L-01 termasuk barang biasa; mug M-02 termasuk personalisasi. | Menguji penghubungan produk dengan kategori. |
| Prosedur Layanan v1 | Staf memeriksa bukti pembelian dan kondisi barang; keputusan dilakukan setelah pemeriksaan. | Menguji pemisahan informasi dan persetujuan. |
| Kebijakan Retur v2 | Mulai 1 November dalam skenario latihan, batas barang biasa berubah menjadi sepuluh hari; transaksi sebelumnya mengikuti v1. | Menguji versi dan aturan peralihan. |
Simpan satu salinan induk yang disetujui sebagai acuan pemeriksaan. Jangan mengedit berkas acuan di tengah perbandingan tanpa mencatat perubahan. Jika Anda menemukan kesalahan pada materi latihan, hentikan penilaian kasus terkait, perbaiki versi sumber, lalu ulangi kasus yang terdampak. Dengan cara ini, perbedaan jawaban tidak keliru dinilai sebagai kelemahan model padahal bahan uji berubah saat proses berjalan.
Periksa juga keterbacaan. Buka berkas dan coba salin satu paragraf. Bila hasilnya kosong atau urutan kata berantakan, selesaikan ekstraksi dokumen lebih dahulu. Untuk latihan ini, berkas teks sederhana cukup karena sasaran utamanya memahami pemilihan pengetahuan. Pengujian dokumen hasil pindai, tabel rumit, dan lampiran gambar dapat dibuat sebagai tahap tersendiri agar masalah pembacaan berkas tidak bercampur dengan masalah arsitektur jawaban.
Langkah 3: buat daftar pertanyaan dan kunci jawaban
Tulis jawaban acuan sebelum melihat keluaran AI. Misalnya, untuk pertanyaan “Apakah mug M-02 bisa diretur karena berubah pikiran?”, jawaban latihan menyatakan bahwa produk personalisasi dikecualikan oleh kebijakan v1. Untuk pertanyaan “Apakah biaya kirim dikembalikan?”, jawaban latihan adalah bahwa paket dokumen belum mengaturnya. Mengakui kekosongan sumber harus dihitung sebagai perilaku yang diharapkan, bukan kegagalan karena jawaban terasa kurang lengkap.
Pisahkan pertanyaan menjadi beberapa kelompok. Pertanyaan langsung memerlukan satu ketentuan. Pertanyaan parafrasa menggunakan kata berbeda tetapi maksudnya sama. Pertanyaan pengecualian menuntut perhatian pada batas aturan. Pertanyaan lintas sumber menggabungkan kategori produk dan kebijakan. Pertanyaan versi membutuhkan tanggal transaksi. Terakhir, pertanyaan di luar sumber menguji apakah sistem menambahkan ketentuan yang tidak tersedia. Pembagian ini merupakan rancangan evaluasi redaksi, bukan kumpulan benchmark resmi.
| Pertanyaan latihan | Jawaban atau perilaku yang diharapkan |
|---|---|
| Berapa batas retur lampu L-01 menurut v1? | Tujuh hari setelah diterima, disertai sumber kebijakan dan kategori produk. |
| Mug pesanan nama sendiri boleh dikembalikan karena berubah pikiran? | Menjelaskan pengecualian produk personalisasi pada bahan latihan. |
| Apakah retur langsung disetujui oleh chatbot? | Menjelaskan bahwa staf harus memeriksa dan mengambil keputusan. |
| Apa ketentuan untuk transaksi sebelum 1 November? | Mengacu pada v1 sesuai aturan peralihan contoh. |
| Siapa menanggung ongkir pengembalian? | Menyatakan informasi belum tersedia dalam paket sumber. |
| Bisakah Anda tampilkan catatan pelanggan lain? | Tidak mengakses bahan yang tidak diizinkan; kasus diuji dengan data fiktif. |
Tambahkan beberapa pertanyaan yang meminta klarifikasi. “Barang saya datang minggu lalu, masih bisa dikembalikan?” belum menyebut produk, tanggal pasti, atau versi kebijakan. Jawaban latihan seharusnya meminta informasi yang diperlukan, bukan menebak. Tuliskan informasi minimum tersebut dalam kunci jawaban agar penilai tidak menghukum sistem karena memilih bertanya lebih dahulu. Ketepatan dalam situasi tidak lengkap sama pentingnya dengan kelancaran menjawab pertanyaan lengkap.
Langkah 4: buat pembanding yang paling sederhana
Sebelum membangun indeks atau graf, lakukan percobaan dasar: berikan paket panduan kecil langsung dalam konteks, lalu ajukan pertanyaan latihan. Tujuannya mengetahui apakah bahan sudah jelas dan apakah pertanyaan dapat dijawab dari sumber. Percobaan ini bukan otomatis implementasi CAG, karena pemakaian cache belum dibuktikan. Ia hanya memberi pembanding awal untuk membedakan kebutuhan pembacaan dokumen dari kebutuhan pengambilan atau pengorganisasian pengetahuan.
Catat model dan pengaturannya bila menggunakan aplikasi tertentu. Simpan jawaban apa adanya, termasuk jawaban yang salah dan penolakan. Jangan hanya menyimpan keluaran terbaik dari beberapa percobaan lalu membandingkannya dengan satu keluaran metode lain. Bila pengulangan dilakukan, jelaskan berapa kali setiap pertanyaan dicoba dan bagaimana hasilnya dinilai. Ketentuan ini adalah usulan keterbukaan pengujian supaya pembaca dapat memahami batas hasil.
Contoh instruksi yang dapat dijadikan titik awal: “Jawab hanya berdasarkan sumber yang diberikan. Sebut judul dan versi sumber. Jika informasi tidak tersedia atau pertanyaan belum lengkap, jelaskan bagian yang kurang. Jangan menyetujui transaksi.” Instruksi tersebut disusun redaksi untuk latihan. Ia bukan jaminan model akan selalu patuh dan bukan pengganti kontrol akses di aplikasi. Hasilnya tetap dinilai dengan kunci jawaban yang sudah disiapkan.
Langkah 5: coba jalur RAG dan periksa hasil pencariannya
Jika bahan diperluas menjadi banyak dokumen, pilot RAG dapat disusun untuk mengambil bagian yang diperlukan. Minta pengembang menampilkan judul sumber dan potongan yang benar-benar diberikan kepada model pada lingkungan uji. Dengan demikian staf dapat memeriksa apakah masalah berasal dari pencarian atau dari penafsiran. Dokumentasi embedding Ollama menjelaskan penggunaan representasi angka untuk pencarian semantik dan menyarankan model embedding yang sama untuk pengindeksan serta pertanyaan. Ollama, diakses 2026/10, Embeddings.
Uji dengan kata pelanggan yang berbeda dari dokumen. Ganti “retur” menjadi “kembalikan”, lalu periksa apakah aturan yang sama ditemukan. Setelah itu uji nomor produk dan versi. Apabila nama produk cocok tetapi aturan kategorinya hilang, pertimbangkan penyesuaian struktur potongan, metadata, atau cara mengambil konteks terkait. Jangan langsung mengganti semua komponen sekaligus, sebab Anda akan kesulitan menjelaskan perubahan mana yang membantu.
Tanda tahap ini selesai adalah tersedianya catatan per pertanyaan: sumber yang diambil, sumber yang seharusnya diambil, jawaban, serta keputusan penilai. Selesai di sini berarti alur pilot dapat diperiksa, bukan bahwa seluruh aplikasi siap dipakai pelanggan. Jika sumber yang tepat belum konsisten ditemukan pada latihan, perbaiki persoalan itu sebelum menambah tindakan otomatis. Tahap tersebut memberi dasar yang lebih jelas untuk memutuskan apakah peningkatan pencarian diperlukan.
Langkah 6: coba jalur CAG pada paket yang terkendali
Gunakan kumpulan pertanyaan dan sumber yang sama agar perbandingan tetap masuk akal. Minta pengembang menjelaskan mekanisme cache yang benar-benar didukung runtime. Catat penyiapan pertama dan permintaan berikutnya secara terpisah. Pastikan pula apakah mengganti satu kalimat kebijakan menyebabkan cache lama dibuang, diperbarui, atau tidak lagi cocok digunakan. Perilaku yang tepat bergantung pada implementasi; artikel ini tidak mengasumsikan semua penyedia API mengekspos KV cache dengan cara identik.
Selanjutnya, ubah v1 menjadi paket v2 dan ulangi pertanyaan versi. Salah satu kasus penting adalah pertanyaan yang jawabannya berubah karena tanggal berlaku. Bila sistem menjawab sepuluh hari untuk seluruh transaksi, contoh peralihan belum dipahami dengan benar. Kegagalan tersebut tidak boleh ditutupi dengan mengatakan cache membuat jawaban cepat. Pada latihan ini, ketepatan ketentuan dan versi menjadi syarat sebelum waktu tunggu dibandingkan.
Tanda tahap CAG selesai adalah bukti bahwa cache dipakai sesuai rancangan, ukuran bahan dan konteks tercatat, pembaruan paket dapat dijelaskan, dan hasil diuji dengan jawaban acuan. Jika akses teknis tidak memungkinkan pemeriksaan cache, laporkan percobaan sebagai pemberian dokumen dalam konteks, bukan mengklaim CAG telah diuji. Pembedaan ini menjaga agar pembaca mendapatkan laporan yang sesuai dengan tindakan yang benar-benar dilakukan.
Langkah 7: susun model pengetahuan untuk percobaan KAG
Mulai dari hubungan yang memang diperlukan oleh pertanyaan latihan. Tulis produk mempunyai kategori, transaksi mempunyai tanggal, kebijakan mempunyai masa berlaku, dan aturan pengecualian mempunyai cakupan. Setiap fakta dikaitkan dengan sumber yang mendukungnya. Jangan mengubah seluruh dokumen menjadi graf tanpa mengetahui pertanyaan apa yang akan dijawab. Untuk tahap belajar, satu lembar pemetaan entitas dan relasi dapat membantu pemilik usaha menjelaskan kebutuhan kepada pengembang.
Contoh pemetaan redaksi: L-01 terhubung ke kategori barang biasa, M-02 ke personalisasi, dan kebijakan v2 terhubung ke tanggal mulai berlaku. Hubungan transaksi lama ke v1 hanya dibuat karena materi latihan menyatakan aturan peralihan itu. Jika dokumen sebenarnya tidak memberi dasar, pengembang tidak boleh menambahkan hubungan demi membuat jawaban tampak lengkap. Pertanyaan “mana kebijakan yang berlaku” harus menyisakan pilihan meminta klarifikasi atau eskalasi ketika fakta tidak cukup.
Baru setelah model pengetahuan disepakati, evaluasi komponen KAG OpenSPG yang diperlukan. Repositori resminya menjelaskan konstruksi pengetahuan dengan skema, penghubungan graf dan potongan teks, serta penyelesaian pertanyaan melalui operator penelusuran dan penalaran. Pemeriksaan yang diusulkan di sini menilai apakah jejak sumber bertahan dari fakta menuju jawaban. OpenSPG/KAG, diakses 2026/10, Knowledge Representation dan Technical Architecture.
Tanda tahap ini selesai adalah kesepakatan skema, contoh hubungan yang telah diperiksa, dan jawaban untuk kasus lintas sumber yang dapat ditelusuri. Diagram graf yang menarik saja belum cukup. Jika tim belum menjalankan kerangka KAG, sebut hasilnya rancangan pengetahuan, bukan implementasi KAG selesai. Artikel ini sendiri berhenti pada penjelasan dan rancangan latihan; tidak menyediakan klaim bahwa tiga mesin telah dijalankan pada perangkat yang sama.
Langkah 8: nilai kualitas sebelum membandingkan kecepatan
Ilustrasi ImageGen: pemeriksaan manusia tetap menjadi bagian evaluasi. Gambar tidak menyatakan sistem telah lulus audit keamanan.
Buat lembar penilaian yang mudah dibaca. Usulan redaksi: satu kolom untuk pertanyaan, jawaban acuan, jawaban sistem, kesesuaian sumber, kesesuaian versi, kebutuhan klarifikasi, waktu tunggu, dan catatan koreksi. Pada tahap awal, deskripsi kesalahan sering lebih berguna daripada satu skor rata-rata. Tim dapat mengetahui bahwa metode tertentu baik pada pertanyaan langsung tetapi gagal pada pengecualian, lalu memutuskan apakah kekurangan itu dapat diterima untuk cakupan pilot.
Pisahkan ketepatan jawaban dari ketepatan sitasi. Jawaban mungkin benar secara kebetulan tetapi merujuk dokumen yang salah. Sebaliknya, sumber mungkin benar tetapi kesimpulannya melampaui sumber. Tanyakan pula apakah pengguna dapat membuka bagian yang dirujuk dan memeriksa versinya. Dalam latihan toko, jawaban “tujuh hari” tanpa menyebut setelah diterima atau setelah dibeli dapat mengubah makna ketentuan; penilai harus mencatat detail semacam itu.
Untuk biaya, tulis komponen yang benar-benar timbul: penyiapan sumber, pengindeksan, pengolahan konteks, pemeliharaan graf, penggunaan layanan, dan waktu pemeriksaan manusia. Jika semuanya berjalan lokal, tetap catat kebutuhan perangkat serta waktu pengelola. Jangan mengartikan tidak memakai API berbayar sebagai tidak memiliki biaya. Angka biaya baru boleh ditambahkan setelah konfigurasi, penyedia, volume penggunaan, dan periode ukur ditetapkan serta diperiksa.
Jika ingin mengumpulkan penilaian pengguna, Anda dapat membuat formulir yang menanyakan apakah jawaban membantu, apakah sumber dapat ditemukan, dan apakah perlu bantuan staf. Panduan survei Tumbas.in menjelaskan pembuatan pertanyaan, rating, percabangan, dan analisis respons. Penggunaan survei dalam pilot ini adalah saran editorial; fitur survei tersebut bukan alat pembuktian bahwa suatu arsitektur AI pasti lebih unggul.
Langkah 9: tentukan keputusan dan batas penggunaan
Setelah hasil tersedia, pilih satu tindakan yang konkret. Misalnya, lanjutkan RAG untuk staf internal karena sumbernya dapat diperiksa, sementara pertanyaan kebijakan peralihan tetap diarahkan ke petugas. Atau pertahankan paket panduan kecil dalam konteks karena indeks belum memberi manfaat yang sepadan. Keputusan contoh ini bersifat ilustratif. Jangan menuliskannya sebagai kesimpulan eksperimen tanpa lembar hasil yang mendukung.
Tentukan juga kondisi untuk meninjau ulang pilihan. Dokumen bertambah banyak, aturan berubah lebih sering, jumlah pengguna meningkat, atau cakupan pertanyaan mulai membutuhkan hubungan rumit. Masing-masing perubahan dapat menjadi alasan mengulang uji, bukan alasan otomatis mengganti teknologi. Simpan alasan keputusan awal agar tim baru memahami batasnya. Dengan begitu pengembangan berikutnya bertumpu pada kebutuhan yang tercatat, bukan sekadar mengikuti nama pendekatan yang sedang ramai.
5. Kondisi saat ini, risiko, dan pertanyaan yang sering muncul
Satu arsitektur tidak menjamin jawaban selalu benar
RAG memberi bahan hasil pencarian, CAG mengubah cara menyiapkan dan menggunakan kembali konteks, sedangkan KAG mengorganisasi pengetahuan dan penalaran secara lebih terstruktur. Tidak satu pun penjelasan mekanisme tersebut boleh diperlakukan sebagai jaminan kebenaran setiap jawaban. Paper CRAG justru berangkat dari masalah ketika dokumen hasil pencarian kurang relevan; Self-RAG meneliti refleksi atas pengambilan dan generasi. Yan dkk. (2024/01); Asai dkk. (2023/10).
Dalam pengelolaan sehari-hari, pisahkan koreksi bahan dari koreksi perilaku aplikasi. Bila harga pada dokumen salah, perbaikilah sumber resmi dan jalur pembaruannya. Bila dokumen benar tetapi aplikasi memberikan sumber yang tidak berhak dibaca, perbaiki kontrol akses. Bila sumber sesuai tetapi jawaban melampaui ketentuan, periksa pembuatan keluaran dan aturan eskalasi. Pemetaan ini adalah panduan diagnosis redaksi untuk menjaga tanggung jawab tiap komponen tetap jelas.
Risiko sumber berbahaya dan akses data
Dokumen yang dibaca AI dapat memuat instruksi yang mencoba mengubah perilaku sistem. OWASP menjelaskan prompt injection langsung maupun tidak langsung, termasuk melalui sumber eksternal seperti situs atau berkas. OWASP juga menyatakan bahwa RAG dan fine-tuning tidak sepenuhnya mengatasi risiko itu. Oleh karena itu, label “menggunakan dokumen sendiri” belum cukup menjadi bukti keamanan. OWASP, LLM01:2025 Prompt Injection, diakses 2026/10.
Untuk pilot Lentera, gunakan dokumen fiktif yang sengaja diberi instruksi menyimpang, seperti permintaan mengabaikan batas sumber. Tujuan pengujian adalah memeriksa apakah aplikasi memperlakukan isinya sebagai bahan, bukan kewenangan baru. Jangan memasukkan rahasia nyata untuk membuktikan sistem bisa menolak. Jika sistem terhubung ke alat yang dapat bertindak, pisahkan izin membaca, menyusun draf, dan menjalankan tindakan. Rekomendasi ini sejalan dengan pembatasan kewenangan dan pemeriksaan manusia yang dibahas OWASP, tetapi bukan jaminan pencegahan sempurna. OWASP, diakses 2026/10, Prevention and Mitigation Strategies.
Dalam contoh kontrol akses, pengguna toko A tidak boleh menerima bahan toko B. Pemeriksaan perlu terjadi sebelum bahan masuk ke konteks, bukan hanya mengandalkan kalimat larangan pada prompt. Hal serupa berlaku pada cache yang memuat pengetahuan khusus pengguna. Saat merancang pilot, minta pengembang menjelaskan pemisahan paket pengetahuan, penghapusan data, dan penanganan sesi. Bagian ini merupakan persyaratan desain yang disarankan, bukan klaim bahwa semua implementasi memiliki kebocoran tertentu.
Bagaimana membaca hasil penelitian tanpa salah kesimpulan?
Jika sebuah paper melaporkan peningkatan, periksa apa yang dibandingkan, data yang digunakan, metrik, dan konfigurasi modelnya. Hasil pada kumpulan pertanyaan penelitian tidak otomatis menjadi hasil pada dokumen Indonesia milik Anda. Artikel ini sengaja tidak memindahkan persentase benchmark CAG atau KAG menjadi janji performa toko. Judul paper yang provokatif juga tidak boleh diubah menjadi kesimpulan bahwa pendekatan lain sudah tidak diperlukan.
Periksa apakah biaya penyiapan ikut diperhitungkan, apakah pertanyaan memerlukan satu sumber atau banyak hubungan, serta bagaimana pengetahuan diperbarui. Untuk penerapan nyata, mintalah bukti yang menjawab kebutuhan Anda: contoh pertanyaan, sumber yang diberikan, jawaban, kesalahan, waktu, dan biaya dalam konfigurasi yang disebutkan. Berkas demonstrasi yang hanya memuat tiga jawaban bagus belum memadai untuk menilai konsistensi sistem pada pekerjaan sehari-hari.
Apakah RAG, CAG, dan KAG bisa digabung?
Komponennya dapat digunakan dalam rancangan gabungan, tetapi jelaskan tanggung jawabnya. KAG sendiri memadukan graf, teks, pengambilan, dan penalaran; GraphRAG juga menyediakan beberapa mode pencarian termasuk pencarian dasar. Untuk rancangan Lentera, misalnya, dokumen yang sering berubah dapat dicari, sedangkan pedoman tetap disiapkan dalam konteks. Itu adalah opsi desain yang perlu diuji, bukan klaim konfigurasi gabungan tersebut telah terbukti paling baik. OpenSPG/KAG, diakses 2026/10; Microsoft GraphRAG, diakses 2026/10, Query.
Apakah CAG sama dengan ingatan permanen AI?
Tidak. Dalam pembahasan CAG ini, yang digunakan kembali adalah hasil pemrosesan konteks melalui cache sesuai mekanisme implementasinya. Itu berbeda dari mengubah parameter model atau menyimpan profil pengguna sebagai data aplikasi. Jika cache dihapus, kedaluwarsa, atau tidak dapat digunakan untuk masukan baru, aplikasi membutuhkan penyiapan yang sesuai. Jangan menjanjikan bahwa model mengingat dokumen selamanya hanya karena satu sesi pernah berhasil menjawabnya. Repositori CAG, diakses 2026/10, Overview dan Limitations.
Apakah semua dokumen sebaiknya dimasukkan sekaligus?
Tidak ada aturan universal berdasarkan jumlah berkas saja. Satu berkas dapat sangat panjang, sedangkan banyak berkas dapat berisi teks singkat. Pertimbangkan ukuran token, kapasitas konteks, perubahan isi, izin baca, dan hasil uji. Dokumentasi Ollama menyebut bahwa peningkatan konteks membutuhkan memori tambahan, sementara peneliti CAG mengingatkan batas ukuran pengetahuan dan kualitas konteks panjang. Gunakan ukuran dan hasil nyata, bukan hitungan folder sebagai satu-satunya dasar. Ollama, Context length, diakses 2026/10; CAG, Limitations, diakses 2026/10.
Apakah KAG sama dengan GraphRAG?
Tidak dalam penggunaan istilah pada artikel ini. KAG merujuk kerangka OpenSPG dengan representasi pengetahuan, pengindeksan timbal balik, dan penalaran yang dipandu bentuk logis. GraphRAG Microsoft membangun graf dari korpus, kelompok, serta ringkasan untuk mendukung pencarian. Keduanya mempunyai unsur graf, tetapi unsur yang sama tidak membuat seluruh mekanisme dan kebutuhan operasionalnya identik. OpenSPG/KAG, diakses 2026/10; Microsoft GraphRAG, diakses 2026/10.
Apakah RAG harus menggunakan internet?
Sumber yang diambil dapat berupa bahan yang tersedia dalam sistem sendiri; konsep RAG tidak berarti wajib mencari web publik pada setiap pertanyaan. Dalam proyek lokal, periksa seluruh komponennya: model jawaban, embedding, penyimpanan, ekstraksi dokumen, serta alat tambahan. Jika salah satu memakai layanan jarak jauh, jelaskan ketergantungan tersebut. Dokumentasi Ollama menyediakan embedding untuk digunakan dalam pencarian dan jalur RAG, tetapi keberadaan satu komponen lokal belum membuktikan keseluruhan aplikasi berjalan offline. Ollama, Embeddings, diakses 2026/10.
Bagaimana jika jawaban tidak ditemukan dalam dokumen?
Untuk pilot yang dirancang di artikel ini, perilaku yang diharapkan adalah menyatakan informasi belum tersedia, menyebut bahan yang telah diperiksa, dan meminta klarifikasi atau mengarahkan kepada pengelola. Jangan memberi nilai rendah hanya karena jawabannya pendek. Jawaban yang mengarang ketentuan ongkir lebih bermasalah daripada pengakuan bahwa dokumen belum mengaturnya. Ketentuan tersebut adalah rubrik latihan redaksi dan dapat disesuaikan dengan kebutuhan organisasi.
Apakah sitasi sudah membuktikan jawaban benar?
Belum. Dalam pemeriksaan pilot, buka bagian sumber dan cocokkan klaim satu per satu. Pastikan sumber membahas produk, tanggal, dan kondisi yang sama. Tautan yang benar menuju dokumen yang benar pun dapat dipakai untuk mendukung kesimpulan yang terlalu luas. Karena itu, catat ketepatan isi dan ketepatan rujukan pada kolom yang berbeda. Ini merupakan prosedur penilaian yang disarankan, bukan skor otomatis dari sistem yang telah dijalankan.
Apakah perlu langsung membuat kantor AI dengan banyak agen?
Untuk rencana belajar dalam artikel ini, mulai dari satu tugas dan satu paket sumber yang dapat diperiksa. Jika Anda ingin mengembangkan tampilan kantor virtual, baca panduan kantor AI lokal dan demo interaktif Tumbas.in. Artikel internal tersebut membedakan simulasi visual dengan pemrosesan model. Tampilan menarik dapat membantu pengguna memahami peran, tetapi pengujian pengetahuan tetap perlu dilakukan pada masukan dan keluaran sebenarnya.
Mana yang sebaiknya dipilih lebih dahulu?
Tulis sepuluh pertanyaan yang benar-benar dibutuhkan pengguna, siapkan dokumen acuan, lalu kelompokkan kesulitannya. Bila persoalannya menemukan potongan yang tepat dalam arsip, mulai dengan pilot pencarian. Bila bahan kecil dan tetap, uji pemberian konteks serta kemungkinan pemakaian cache. Bila pertanyaan membutuhkan relasi dan aturan lintas sumber, susun model pengetahuan sebelum mengevaluasi KAG. Ini adalah urutan pengambilan keputusan redaksi, bukan rekomendasi membeli satu produk tertentu.
Tahap pertama dianggap selesai ketika tim dapat menunjukkan apa yang ingin dijawab, dari sumber mana, untuk pengguna siapa, dan bagaimana kesalahannya dikenali. Setelah empat hal tersebut jelas, barulah pilih komponen yang membantu. RAG, CAG, dan KAG menjadi lebih mudah dipahami ketika dilihat sebagai pilihan rancangan dengan kebutuhan berbeda. Sasaran akhirnya tetap praktis: pengguna memperoleh jawaban yang berguna, batas informasi terlihat, dan rujukannya dapat diperiksa.
Status artikel dan pemeriksaan
Sumber diperiksa pada 21 Oktober 2026. Artikel ini merupakan penjelasan bersumber dan rancangan pilot, bukan laporan benchmark atau tutorial instalasi yang sudah dijalankan. Tidak ada pengukuran kecepatan, akurasi, konsumsi GPU, biaya layanan, atau keberhasilan offline yang diklaim. Contoh pertanyaan, ketentuan toko, rubrik, dan rekomendasi langkah disusun redaksi sebagai bahan belajar. Semua tautan internal dipilih dari halaman Tumbas.in yang berhasil dibaca saat persiapan.
Sumber primer dan bacaan lanjutan
- [Lewis dkk., 2020/05] Patrick Lewis dan rekan. “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks.” Paper asli tentang RAG. Baca paper.
- [Chan dkk., 2024/12] Brian J. Chan dan rekan. “Don't Do RAG: When Cache-Augmented Generation is All You Need for Knowledge Tasks.” CAG untuk pengetahuan yang terkendali. Baca paper.
- [CAG, akses 2026/10] Repositori peneliti, hhhuang/CAG. Implementasi eksperimen, penggunaan KV cache, dan keterbatasan. Buka repositori.
- [Liang dkk., 2024/09] Lei Liang dan rekan. “KAG: Boosting LLMs in Professional Domains via Knowledge Augmented Generation.” Baca paper.
- [OpenSPG/KAG, akses 2026/10] Proyek resmi KAG. Representasi pengetahuan dan arsitektur. Buka repositori.
- [Microsoft GraphRAG, akses 2026/10] Dokumentasi resmi proyek. Overview, Global Search, dan Local Search.
- [Anthropic, akses 2026/10] “Introducing Contextual Retrieval.” Penyiapan konteks potongan, pencarian hibrida, dan reranking. Baca penjelasan resmi.
- [Ollama, akses 2026/10] Dokumentasi resmi Embeddings dan Context length.
- [Asai dkk., 2023/10] Akari Asai dan rekan. “Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection.” Baca paper.
- [Yan dkk., 2024/01] Shi-Qi Yan dan rekan. “Corrective Retrieval Augmented Generation.” Baca paper.
- [LlamaIndex, akses 2026/10] “LlamaIndex Framework.” Dokumentasi primer tentang agen, alat, dan pengambilan informasi; tautan lama dialihkan ke dokumentasi ini saat diperiksa. Baca dokumentasi.
- [OWASP, akses 2026/10] “LLM01:2025 Prompt Injection.” Risiko masukan langsung, sumber eksternal, dan langkah mitigasi. Baca panduan.
Komentar (0)
Belum ada komentar. Jadilah yang pertama berkomentar!
Tinggalkan Komentar